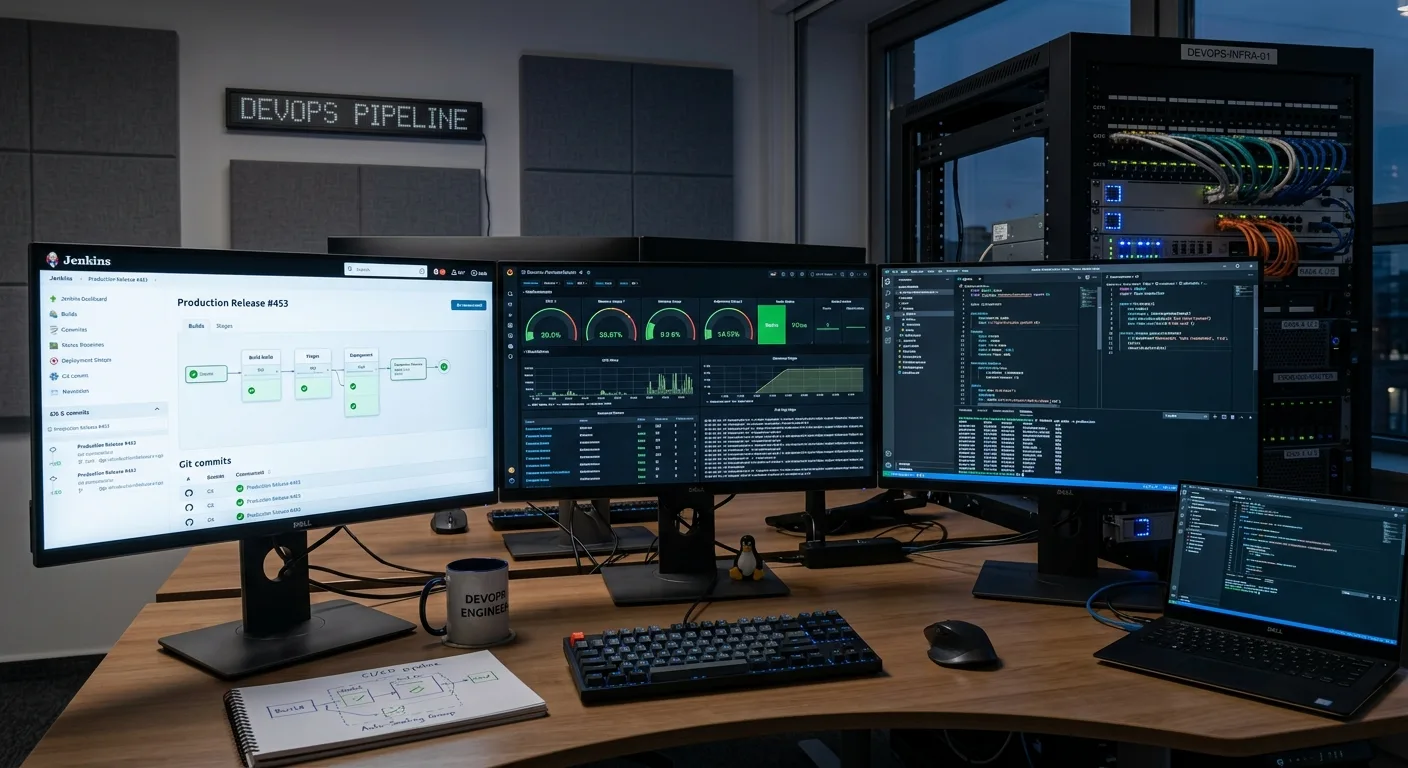
Zašto je monitoring kritičan u dinamičnim DevOps okruženjima?
Dinamična DevOps okruženja, s čestim implementacijama i mikroservisnim arhitekturama, zahtijevaju stalni nadzor. Bez robusnog monitoringa, problemi mogu ostati neotkriveni dugo vremena, što dovodi do prekida rada i negativnog utjecaja na korisničko iskustvo. Pravovremeno uočavanje anomalija ključno je za održavanje kontinuiteta poslovanja.
Kontinuirani monitoring omogućuje timovima da prate performanse aplikacija i infrastrukture u realnom vremenu. To im pomaže da brzo identificiraju uska grla, potencijalne sigurnosne prijetnje i neočekivano ponašanje sustava prije nego što eskaliraju u ozbiljne incidente. Tako se smanjuje vrijeme zastoja i osigurava stabilnost.
Vrste metrika za praćenje performansi aplikacija i infrastrukture
Za učinkovit monitoring, važno je pratiti različite vrste metrika. To uključuje metrike performansi aplikacija kao što su vrijeme odziva, broj grešaka i propusnost, te metrike infrastrukture poput iskorištenosti CPU-a, memorije, diska i mrežnog prometa. Kombinacija ovih podataka daje cjelovitu sliku zdravlja sustava.
Osim toga, važno je pratiti i poslovne metrike koje su izravno povezane s korisničkim iskustvom i poslovnim ciljevima. Primjerice, broj uspješnih transakcija, vrijeme učitavanja stranice ili broj aktivnih korisnika. Integracija svih ovih metrika u jedinstveni dashboard omogućuje brzi pregled stanja.
Pravi uvid u sustav ne dolazi samo iz prikupljanja podataka, već iz sposobnosti da se ti podaci razumiju i djeluje na temelju njih.
Praktični pristupi za centralizirano prikupljanje i analizu logova
Centralizirano logiranje je neophodno za efikasno rješavanje problema u složenim sustavima. Umjesto da se logovi skupljaju s pojedinih servera, oni se agregiraju na jednom mjestu, što omogućuje brzu pretragu, analizu i korelaciju događaja. Alati poput ELK Stacka (Elasticsearch, Logstash, Kibana) ili Splunka su popularni izbori za ovu svrhu.
Analiza logova ne uključuje samo pretragu, već i vizualizaciju trendova i anomalija. Korištenjem parsera i filtara, timovi mogu izvući relevantne informacije iz ogromne količine podataka. To omogućuje brže prepoznavanje uzroka problema i proaktivno djelovanje na temelju uvida u ponašanje sustava.
Korištenje alarma i obavijesti za proaktivno rješavanje problema
Proaktivno rješavanje problema zahtijeva učinkovit sustav alarma i obavijesti. Konfiguracija pragova za metrike i logove omogućuje automatsko generiranje upozorenja kada sustav odstupi od očekivanog ponašanja. Obavijesti se mogu slati putem e-maila, SMS-a, Slacka ili drugih komunikacijskih kanala, osiguravajući da relevantni timovi budu odmah informirani.
Važno je pažljivo kalibrirati alarme kako bi se izbjegao 'šum' i osiguralo da su obavijesti relevantne i djelotvorne. Definiranje jasnih protokola za odgovor na različite vrste alarma pomaže timovima da brzo i učinkovito reagiraju na incidente, smanjujući potencijalnu štetu i vrijeme oporavka sustava.